 README
- ESevenZError
- TArchiveFile
- ::newByteReader::new
- ::positionByteReader::position
- ::read_bitfieldByteReader::read_bitfield
- ::read_booleansByteReader::read_booleans
- ::read_byteByteReader::read_byte
- ::read_bytesByteReader::read_bytes
- ::read_digestsByteReader::read_digests
- ::read_numberByteReader::read_number
- ::read_u32ByteReader::read_u32
- ::read_u64ByteReader::read_u64
- ::remainingByteReader::remaining
- ::requireByteReader::require
- ::skipByteReader::skip
- TCoder
- ::finalizeCrc32::finalize
- ::newCrc32::new
- ::updateCrc32::update
- TEntry
- TFolder
- ::bytesSevenZ::bytes
- ::entriesSevenZ::entries
- ::extractSevenZ::extract
- ::extract_allSevenZ::extract_all
- ::openSevenZ::open
- ::sizeSevenZ::size
- ::start_headerSevenZ::start_header
- ::streamsSevenZ::streams
- ::absolute_endStartHeader::absolute_end
- ::absolute_offsetStartHeader::absolute_offset
- TStreams
- Vcopy_range
- Vcrc32
- Vhex_byte
- Vhex_id
- Vhex_string
- Vlzma1_decode
- Vlzma2_decode
- Vsevenz_signature
- Vsevenz_start_header_size
moon7z
纯 MoonBit 实现的 7z 归档只读解包库:容器解析 + LZMA/LZMA2 解码内核(库本体零第三方依赖)
7z
archive
lzma
lzma2
extract
wasm
Author
Version
0.1.0
License
Apache-2.0
Repository
Last updated
12 days ago
Downloads
27
#moon7z
纯 MoonBit 实现的 7z 归档只读解包库(.7z / 7-Zip 容器),目标后端 wasm-gc。
库本体零第三方依赖(只用 MoonBit 标准库);只有可运行的命令行示例 cmd/main 用
moonbitlang/x 读文件。
状态:0.1.0 开发中。已实现起始头校验、明文头解析、编码头(LZMA/LZMA2 压缩的头)解码、 条目表与端到端解包(COPY / LZMA1 / LZMA2)。 也就是说:bsdtar 或 7-Zip 生成的普通 7z(明文头或 LZMA/LZMA2 压缩头)都可以列目录并解出内容。
| 能力 | 状态 |
|---|---|
| 起始头 / 两处 CRC-32 / 边界校验 | ✅ |
| 明文头(kHeader):属性树、Folder/Coder、SubStreams、文件表 | ✅ |
| 编码头(kEncodedHeader):用 LZMA1/LZMA2 解出被压缩的头 | ✅ |
| 解包 coder:COPY(0x0) / LZMA1(0x030101) / LZMA2(0x21) | ✅ |
| 目录、空文件、非 ASCII(UTF-16)文件名、Solid 块、多子流 | ✅ |
| 过滤器链(BCJ/Delta 等前置 coder)、AES 加密、分卷、BCJ2、PPMd/BZip2/Deflate | ❌ 明确不做(报 Unsupported) |
#为什么做这个
MoonBit 生态里归档格式已经很全:zip、tar、gzip/deflate、brotli、xz/lzma 都有纯
MoonBit 实现,唯独 7z 没有——而 7z 是 Windows 上最常见的分发格式。
已有的相邻项目层次不同:
| 包 | 覆盖范围 |
|---|---|
| TWISTY2Ynb/moonmspack | CAB / CHM / MSZIP / LZX(Microsoft 容器族) |
| aurora0x27/lzma-mbt、lin2077-zeming/moonxz | .xz / .lzma 单流格式的编解码 |
| moon7z(本项目) | 7z 归档容器:属性树、Folder/Coder 图、文件表、Solid 块与解包 |
#安装与使用
moon add Sxy11112/moon7z # 作为依赖加入你的 MoonBit 项目最小使用样例(不读文件,直接给字节):
fn demo(bytes : Bytes) -> Unit raise {
  let z = @moon7z.SevenZ::open(bytes)
  for e in z.entries() {
    println(e.name + " " + e.size.to_string())   // 目录的 size 为 0,is_dir 为 true
  }
  let files = z.extract_all()                    // [ArchiveFile]:name + data
  println(files.length().to_string() + " 个文件")
}#明确不做(工程边界)
- 只读:不创建、不修改、不追加 7z 归档;
- 不支持 AES 加密、分卷(multi-volume)、BCJ2;
- 不支持过滤器链(BCJ / Delta 等前置 coder,可执行文件常见)——遇到时报 Unsupported;
- 不支持 PPMd / BZip2 / Deflate 等其它 coder;
- 不支持 RAR / ACE 等其他归档格式。
#演示
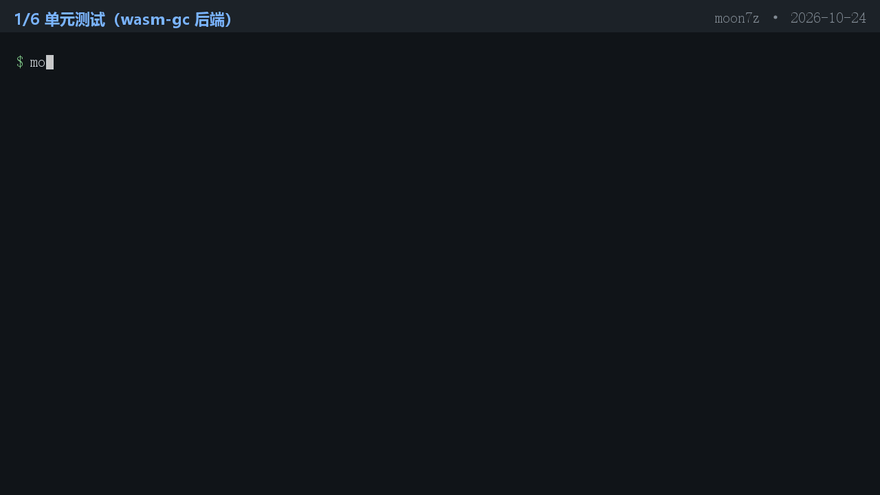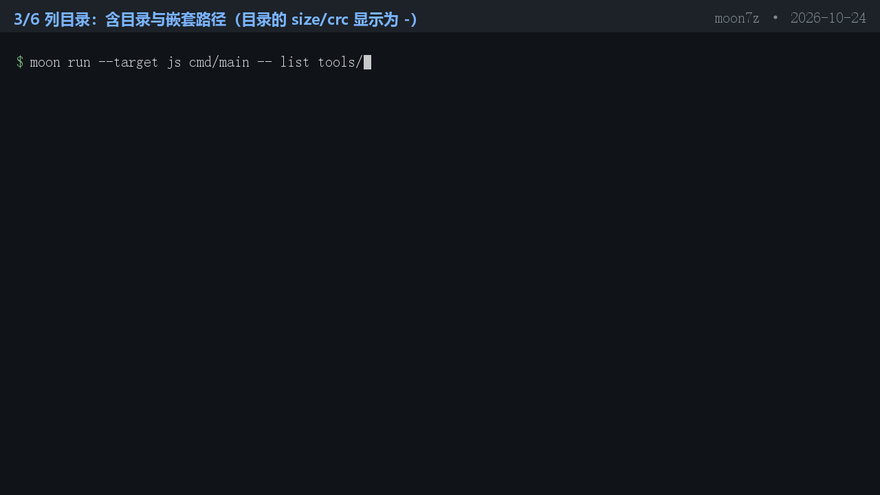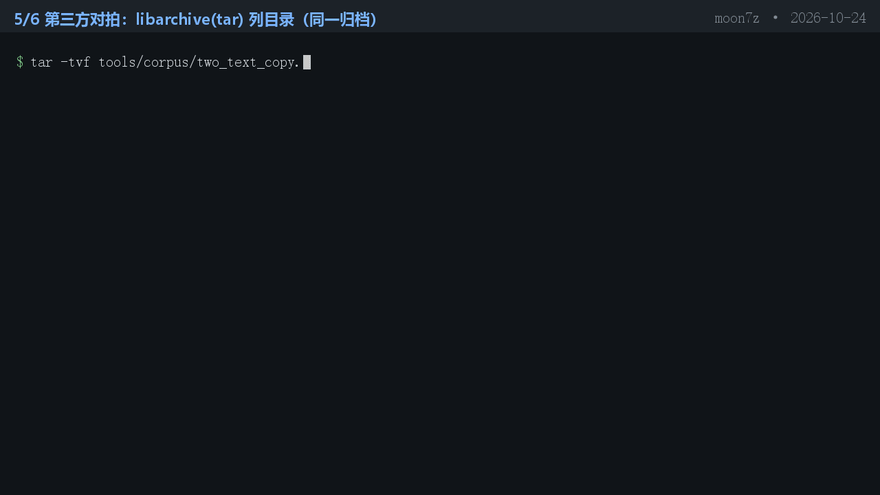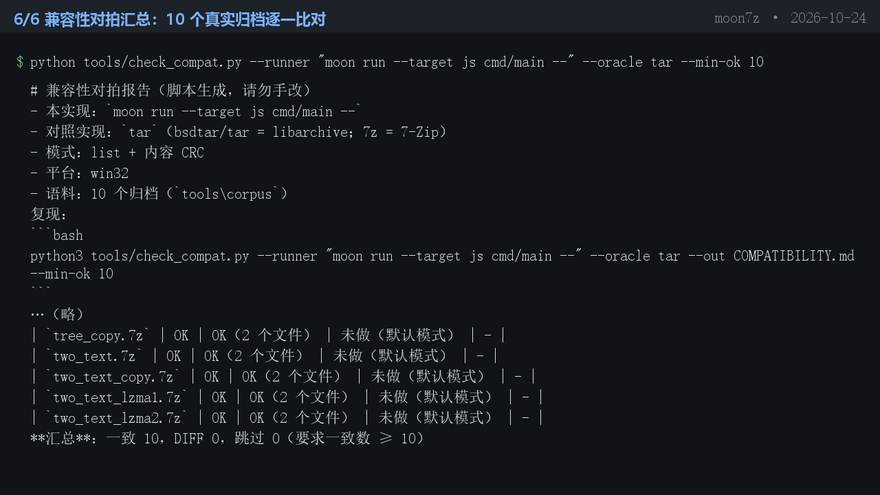
(完整 30 秒 MP4:docs/demo.mp4。用 python tools/make_demo.py 可重新生成:
脚本现场执行 moon test、cmd/main list、cmd/main extract、tar -tvf 对拍、
tools/check_compat.py 汇总,并把真实输出渲染成视频。)
#当前可用的 API
let z = @moon7z.SevenZ::open(bytes)   // 校验签名、版本、两处 CRC-32 与偏移边界

// F1:起始头
let sh = z.start_header()
println(sh.minor)                     // 归档次版本号(bsdtar 写 0.3,官方写 0.4)
println(sh.absolute_offset())         // 头数据库在文件中的绝对起点

// 条目表与流信息
let entries = z.entries()             // [Entry]:name / size / crc / is_dir
let streams = z.streams()             // 打包位置与大小、Folder/coder 链、子流大小与 CRC

// 解包(COPY / LZMA1 / LZMA2)
let files = z.extract_all()           // [ArchiveFile]:目录跳过,空文件为空 Bytes
let one = z.extract("a.txt")          // 按名字取单个文件
所有输入都当作外部不可信数据:截断、签名不符、版本不支持、CRC 不符、偏移越界、
属性树非法、压缩码流损坏都返回结构化的 SevenZError(含 LzmaCorrupt),不会 panic。
#两个实测得到的格式细节
kName 块的两种形态:按格式说明名字块是 UTF-16LE、每名以 0x0000 结束。但实测
libarchive(bsdtar)写出的块首多一个 0x00 字节,而且 libarchive 只接受这种形态
(把该字节去掉后 tar -tf 报 Damaged,见 tools/gen_fixtures.py 的构造注释)。
本实现两种形态都支持:判据不是"名字个数是否等于 numFiles"(两种形态都能凑出同样的个数,
libarchive 形态会解出乱码名字),而是整个块必须被精确消费完,只有满足该条件的偏移才被接受。
LZMA2 的 LZMA 块头是 ctrl, unpack-1(2B 大端), packed-1(2B 大端), [ctrl>=0xC0 时 1B props],
控制字节语义为:0x80-0x9F 无复位;0xA0-0xBF state 复位(无 props);0xC0-0xDF
state 复位 + props;0xE0-0xFF 再叠加字典复位;0x01/0x02 为未压缩块。
另外 LZMA1 裸流的尾部可能有编码器 flush 但解码器用不到的字节(实测某向量只消费 29/34),
因此判据是"是否产出声明的 unpack_size",而不是"是否消费完所有输入"。
#验证方式
- 真实语料由 bsdtar(Windows 自带 tar.exe / libarchive)生成: python tools/gen_fixtures.py(默认保留已提交的语料,--force 才重生成,--only <名字> 只处理一个);
- 期望值来自独立来源:tar -tvf 的列目录结果、tar -xf 解出的文件字节 (生成脚本会在生成时用 libarchive 解包并与写入内容逐字节比对)、Python zlib.crc32 算出的内容 CRC;
- CRC-32 用标准检查值(zlib)做已知答案比对;
- 每个判据都做变异测试(改坏实现必须变红,并记录能抓到什么)。
语料(tools/corpus/):
| 语料 | 压缩 | 说明 |
|---|---|---|
| two_text.7z / two_text_lzma1/2.7z | LZMA/LZMA2 | 编码头(0x17),供 F4/F5 |
| two_text_copy.7z | copy | 明文头,多文件 |
| one_file_copy.7z / tree_copy.7z | copy | 单文件;含目录条目(kEmptyStream) |
| empty_file_copy.7z | copy | 含 0 字节文件(kEmptyStream + kEmptyFile,非目录) |
| nested_copy.7z | copy | 嵌套目录 + 非 ASCII(UTF-16)文件名 |
| big_copy.7z | copy | 20 KB 文件(较大 packed 数据的切片与 CRC) |
| minimal_two_copy.7z | copy | 手工构造的最小两文件归档(libarchive 复核可读) |
#命令行示例(可运行)
# 列目录:每行 "<名字>\t<大小>\t<CRC32>"(目录的 size/crc 为 "-")
moon run --target js cmd/main -- list tools/corpus/two_text.7z

# 解包到目录(自动创建子目录)
moon run --target js cmd/main -- extract tools/corpus/tree_copy.7z /tmp/out
失败时输出 UNSUPPORTED\t<原因> 或 ERROR\t<原因>(跨后端行为一致,便于脚本判断)。
#工程化
- CI(.github/workflows/ci.yml):moon fmt --check、moon check --deny-warn、moon build、 moon test(wasm-gc + js),随后安装 libarchive-tools 与 p7zip-full, 跑 python3 tools/check_compat.py --full-extract 做第三方对拍: 列目录(名字 + 大小)、内容 CRC、以及解包后逐文件 SHA-256。
- 本地(Windows,只有 tar.exe)可跑默认模式: python tools/check_compat.py --runner "moon run --target js cmd/main --" --oracle tar --min-ok 10
- 对拍脚本对本实现明确报 UNSUPPORTED 的归档记为 SKIP;临时目录必须放在 moon 模块之外 (moon 的包发现会扫描模块内所有目录,残留临时目录会让 moon run/check 直接失败)。
#许可
Apache-2.0,见 LICENSE。
SevenZError
pub suberror SevenZError {
  Truncated(offset~ : Int64, need~ : Int64, actual~ : Int64)
  BadSignature(found~ : String)
  UnsupportedVersion(major~ : Int, minor~ : Int)
  BadCrc(what~ : String, expected~ : Int64, actual~ : Int64)
  Malformed(reason~ : String)
  Unsupported(what~ : String)
  LzmaCorrupt(reason~ : String)
}
解析 / 解包 7z 归档时可能出现的错误。
ByteReader
pub struct ByteReader {
  data : Bytes
  pos : Int
}
顺序读取字节的小端游标。
ByteReader::read_bitfield
读 count 个布尔值(裸位域:每字节 8 项、MSB 在前,无 allDefined 前缀)。
FilesInfo 的 kEmptyStream / kEmptyFile / kAnti 用这种形式:它们的 size
字段就是位域字节数(实测 bsdtar 归档:3 个文件 → size=1、内容 0x20)。
ByteReader::read_booleans
读 count 个布尔值(BooleanList)。
ByteReader::read_byte
读 1 字节(0 .. 255)。
ByteReader::read_bytes
读 n 字节并复制成新的 Bytes。
ByteReader::read_digests
读 count 个 CRC-32 摘要(BooleanList 决定哪些位置有值)。
ByteReader::read_number
读一个 7z NUMBER(0 .. 2^64-1)。
ByteReader::read_u32
读小端 UINT32(以 Int64 返回,值域 0 .. 2^32-1)。
ByteReader::read_u64
读小端 UINT64(以 Int64 返回;7z 的实际字段远小于 2^63)。
ByteReader::require
要求剩余至少 need 字节;不足时抛出 Truncated。
ByteReader::skip
跳过 n 字节。
Coder
pub struct Coder {
  id : Int64
  props : Bytes
  num_in : Int
  num_out : Int
}
单个 coder(解压 / 过滤算子)。
Crc32
pub struct Crc32 {
  table : FixedArray[Int64]
  value : Int64
}
增量 CRC-32 计算器。
Folder
Folder:一组 coder 组成的解压单元,也是 Solid 压缩的边界。
SevenZ
已打开的 7z 归档。F1 保证起始头与下一头区间可用;条目列表与解压在后续增量补充。
SevenZ::entries
解析头数据库,返回归档中的条目列表。
输入:SevenZ(起始头已校验)。
输出:条目数组,顺序与归档内文件表一致。
失败:编码头(F5 尚未实现)/ 属性树非法 / 截断 / 名字数与文件数不符。
SevenZ::extract
解出指定名字的文件。找不到时报 Malformed。
SevenZ::extract_all
解出归档中的所有文件。
目录条目会被跳过;"空文件"条目产出长度 0 的 Bytes。
每个 Folder 与子流声明的 CRC-32 都会被校验,不符即报 BadCrc。
SevenZ::open
解析并校验 32 字节起始头,并证明下一头数据库完整落在文件内、CRC 正确。
输入:完整归档字节(至少 32 字节)。
输出:SevenZ,其起始头字段已全部校验通过。
失败:截断 / 签名不符 / 主版本非 0 / 两处 CRC 不符 / 下一头区间越界。
SevenZ::streams
归档的流信息(打包位置与大小、Folder / coder 链、子流大小与 CRC)。
输入:SevenZ(起始头已校验)。
输出:Streams,供解压(后续增量)与压缩方式检查使用。
StartHeader
pub struct StartHeader {
  major : Int
  minor : Int
  next_header_offset : Int64
  next_header_size : Int64
  next_header_crc : Int64
}
已校验的起始头字段。
StartHeader::absolute_end
下一头在归档中的绝对终点(不含)。
StartHeader::absolute_offset
下一头在归档中的绝对起点。
Streams
归档的流信息(PackInfo + UnpackInfo + SubStreamsInfo)。
copy_range
fn copy_range(data : Bytes, start : Int, end : Int) -> Bytes复制 data[start, end) 成新的 Bytes(区间自动裁剪到数据长度内)。
lzma1_decode
解一段 LZMA1 裸流(7z 的 0x030101 coder)。
props 5 字节;data 是裸码流(无 ALONE 头、无 EOS);
输出长度由 unpack_size 决定,尾部多余的输入字节被容忍。
lzma2_decode
解一段 LZMA2 流(7z 的 0x21 coder)。
props 1 字节字典大小编码;data 是含分块头的完整流。
输出达到 unpack_size 即返回,结尾的 0x00 结束标记与尾部多余字节都可以缺失。
Install
Download zip纯 MoonBit 实现的 7z 归档只读解包库:容器解析 + LZMA/LZMA2 解码内核(库本体零第三方依赖)
7zarchivelzmalzma2extractwasm

 Apache-2.0

 Updated 12 days ago
 27 downloads