 README
- Vauto_session
- Vcompare_recordings
- Vrecord_session
- Vreplay_session
- Vsave
mooncassette
Deterministic record-and-replay (cassette) for LLM interactions: write offline, reproducible, drift-detecting regression tests for LLM applications without API keys or network.
llm
testing
record-replay
cassette
vcr
deterministic
mock
regression-testing
Author
Version
0.6.0
License
Apache-2.0
Repository
Last updated
3 hours ago
Downloads
26
Dependencies
- moonbitlang/x0.5.5
#mooncassette
中文 · English


给 LLM 应用做确定性录制与回放 —— 让「调用大模型」这件事变得可以离线、可以复现、可以回归。
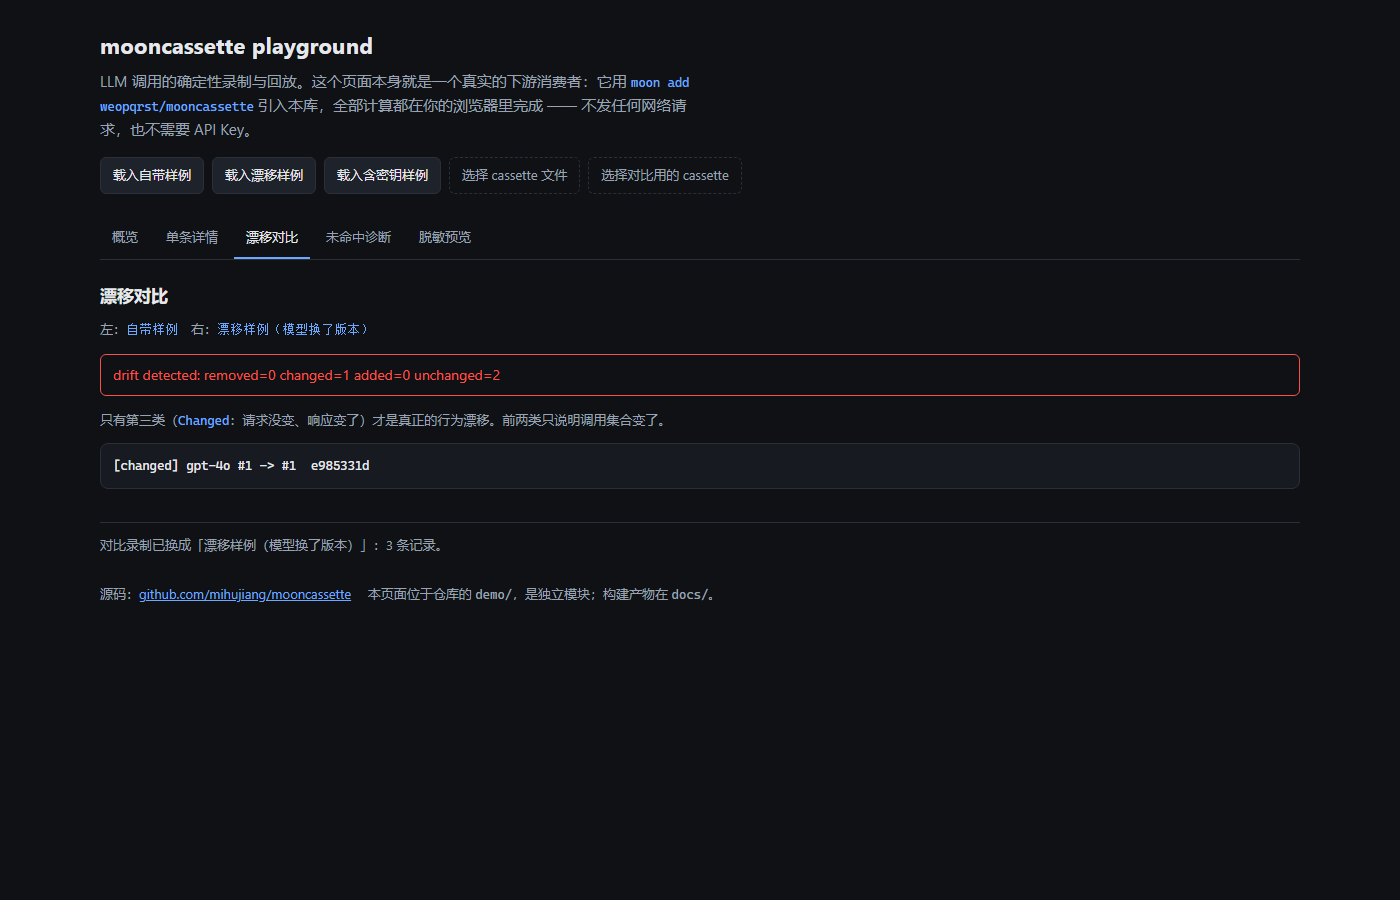
这是浏览器里的 playground:载入两份录制,
一眼看出哪一条的行为变了。全部计算在浏览器内完成,不发任何网络请求。
mooncassette 记录一次真实的 LLM 交互,把它落成一个可读、可 diff 的
cassette 文件;之后无论在 CI、在同事的电脑上、还是在没有网络的飞机上,
测试都会回放出逐字节一致的结果。
#为什么需要它
用 LLM 写应用时,测试是三难的:
| 做法 | 问题 |
|---|---|
| 直接调用真实 API | 慢、贵、不稳定;CI 需要密钥;同一输入两次结果不同 |
| 手写 mock | 每次改 prompt 都要同步改 mock;mock 与真实响应逐渐漂移 |
| 不测 | 改一个 prompt 就得靠手动试,回归无从谈起 |
mooncassette 提供第四条路:录制真实流量,回放确定性结果。
开发阶段   真实调用 ──▶ 录制 ──▶ demo.cassette.json ──▶ 提交进版本控制
测试 / CI 无网络 ──▶ 回放 ──▶ 逐字节一致的结果,零密钥#安装
moon add weopqrst/mooncassette在 moon.pkg 中按需引用:
import {
  "weopqrst/mooncassette",
  "weopqrst/mooncassette/core",
  "weopqrst/mooncassette/providers",
}
已发布在 mooncakes.io。
#30 秒上手
不需要网络,也不需要 API Key:
moon run examples/offline_demo --target js     # 录制 → 落盘 → 回放 → 漂移检测
moon run examples/openai_protocol --target js  # 真实 provider 报文 → 录制 → 离线回放
moon run examples/streaming_demo --target js   # SSE 流式 → 逐帧递给应用 → 离线逐帧回放
moon run cmd/main --target js -- verify examples/demo.cassette.json
moon run cmd/main --target js -- show   examples/demo.cassette.json
moon run cmd/main --target js -- diff   examples/demo.cassette.json examples/demo.drifted.cassette.json
moon test --target wasm-gc#核心保证(不变量)
这些是本项目对外承诺、且有测试守护的性质:
- 回放模式绝不发起真实调用。 Mode::Playback 的会话在构造上就不持有 Transport,因此「不小心打到线上」在类型层面被排除。
- 落盘内容一定经过脱敏,而真实调用一定保留密钥。 同一次业务请求被派生为 两个形态:发给 provider 的保留密钥(否则鉴权会失败),写入 cassette 的已脱敏。 录制与回放两侧走同一条派生链,否则会出现「录得进去、回放不出来」。
- 规范文本是确定的。 对象键按 UTF-8 字节序排序,与 Map 迭代顺序无关, 因此同一份 cassette 在任何后端、任何运行下都产出相同字节。
- 指纹跨目标稳定。 不使用标准库 Hasher(其实现与后端相关), 而是自实现 FNV-1a 64 位,并用官方测试向量校验。
- 指纹相同 ≠ 请求相同。 指纹只用于索引;最终判据是规范文本全等。 一旦检出真实碰撞会显式报错,而不是静默返回错误结果。
- 文件被手工改动一定会被发现 —— 包括响应。 cassette 里保存了两个不同 覆盖范围的摘要,解码时都会重算比对(详见下文「两个摘要」)。
- Interaction 完全确定。 时间戳等非确定字段只允许出现在 CassetteMeta, 从类型结构上杜绝「测试随机挂掉」。
#快速上手
#1. 定义你的 Transport
Transport 是唯一的扩展点,把真实 HTTP 客户端接进来即可。它刻意不含
录制、匹配、脱敏逻辑 —— 那些都由会话引擎负责。
///|
struct MyHttpTransport {
  client : MyHttpClient
}

///|
fn MyHttpTransport::send(
  self : MyHttpTransport,
  request : @core.Request,
) -> @core.Response raise @core.CassetteError {
  let response = self.client.post(request.model, request.body) catch {
    error => raise @core.CassetteError::TransportFailure(error.to_string())
  }
  @core.Response::ok(response.body, usage=response.usage)
}#2. 开发时:自动录制
Auto 模式 = 「命中就回放、未命中就录制」。首次运行会真实调用并写盘,
之后运行完全离线。
let session = @mooncassette.auto_session(
  @core.Cassette::new("chat-demo"),
  MyHttpTransport::new(client),
)
let _ = session.send(request)
// 把结果写入 tests/cassettes/chat-demo.cassette.json 并提交进版本控制
@fs.write_string_to_file(path, @mooncassette.save(session))#3. 测试时:只读回放
///|
test "chat returns the recorded answer" {
  let session = @mooncassette.replay_session(recorded_text)
  let response = session.send(request)
  assert_eq(response.body, Json::string("录下来的答案"))
}
这个测试不需要网络、不需要密钥,且永远稳定。
#接入真实 provider
回放与漂移检测都建立在「统一请求/响应」之上,而真实世界是各家自己的报文格式。
providers 包负责这层翻译,且不依赖任何 HTTP 客户端(因此仍在全部后端可编译,
并且可以用真实报文做离线测试)。
| 协议 | 路径 | 鉴权头 | usage 字段名 |
|---|---|---|---|
| OpenAiChat | /chat/completions | Authorization: Bearer … | prompt_tokens / completion_tokens |
| AnthropicMessages | /messages | x-api-key + anthropic-version | input_tokens / output_tokens |
OpenAiChat 的 base_url 可以指向 DeepSeek、Moonshot、vLLM、Ollama 等兼容端点,
因此一个适配器就能覆盖相当广的范围。
它替你处理掉这些容易出错的地方:
- 各家的路径与鉴权头差异;
- usage 字段命名差异(OpenAI 是 prompt_tokens,Anthropic 是 input_tokens);
- 错误响应也要能录下来——否则「限流时怎么办」没法写回归测试;
- 网关返回 HTML 错误页时不会把响应体丢掉,而是包成 {"raw_body": "…"};
- 报文体中若显式写了 model,必须与 Request.model 一致,否则直接报错 (这类静默不一致会同时污染指纹与计费口径,很难排查)。
#你需要实现的只有「发出去」这一步
///|
let sender = @providers.FunctionSender::new(fn(request) {
  MyClient::call(request) // (HttpRequest) -> HttpResponse raise CassetteError
})

///|
let transport = @providers.ProviderTransport::new(
  @providers.OpenAiChat::new(api_key, base_url="https://api.deepseek.com/v1"),
  sender,
)

///|
let session = @mooncassette.auto_session(@core.Cassette::new("chat"), transport)
api_key 只会进入 HTTP 请求头,永远不会写进 cassette —— cassette 记录的是
统一请求/响应,而不是抓包结果。
#关于异步 HTTP 客户端(重要)
mizchi/x/http 这类客户端是 async 的(async fn post),而 Transport::send 与
HttpSender::send 都是同步的。MoonBit 没有「从同步上下文启动异步任务」的入口
(moonbitlang/async 只提供 spawn,没有 block_on 式的桥接),因此异步客户端
无法实现这两个 trait。
但接入并不麻烦:整条链路里只有「把报文发出去」这一步是异步的,其余全部复用同步 API。
///|
// 命中就回放,未命中就发一次并录下来。
let response = match session.try_replay(request) {
  Some(recorded) => recorded
  None => {
    let http_request = protocol.encode(request) // 同步
    let http_response = my_client.send(http_request) // ← 只有这一步需要 await
    session.record(request, protocol.decode(http_response)) // 同步
  }
}
Session::record 会按与自动录制完全相同的派生链处理请求与响应(规范化 + 脱敏),
因此手工录下的记录与自动录下的记录在 cassette 里形态一致,可以互相回放。
换句话说:这条路径绕开了 Transport,但没有绕开任何不变量。
协议编解码本身与同步/异步无关,所以 encode / decode 两步可以在任何上下文中复用。
若客户端是同步的,则用上面的 FunctionSender 更省事。
#量化指标
只列能在仓库里复算的数字,每项都给出复算方式。
| 指标 | 值 | 复算方式 |
|---|---|---|
| 库包 | 12 个(含门面包) | moon info,或各目录下的 pkg.generated.mbti |
| 生产代码 | 6,214 行 | 排除 *_test.mbt / *_wbtest.mbt(含示例与 CLI) |
| 测试代码 | 4,781 行 | 两类测试文件之和 |
| 测试 | 296 个,wasm-gc 与 js 各跑一遍 | moon test --target wasm-gc / --target js |
| 对抗性用例 | 篡改 20 条 + 脱敏 300 组随机结构 + 解析器 600 组随机输入 + 形状 12 条 | codec/tamper_test.mbt、sanitize/leak_test.mbt、stream/fuzz_test.mbt、codec/shape_test.mbt |
| 演示模块 | 5 个视图;12 个白盒测试 + 端到端冒烟 | demo/ |
规模(确定性:换一台机器也是这些数):
- 一条记录约 815 字节(紧凑编码);
- 紧凑编码比 2 空格缩进省 46%;
- 每条记录的开销从 10 条到 1000 条保持稳定,说明增长是线性的。
吞吐(取决于机器与后端):下表来自一次实测。同一台机器上重跑,绝对值会有
约 ±30% 的波动(机器负载所致,与代码无关),因此真正稳定可比的是数量级与比值 ——
例如「未命中 27 毫秒 vs 命中 32 微秒」这个约三个数量级的差距,才是索引的意义所在。
| 操作 | js | wasm-gc |
|---|---|---|
| 指纹(1 KB 请求) | 19 µs | 4 µs |
| 规范文本(1 KB JSON) | 8 µs | 1 µs |
| 编码(100 条记录) | 7.8 ms | 2.0 ms |
| 解码 + 完整性校验(100 条记录) | 5.8 ms | 1.9 ms |
| 匹配未命中(1000 条,带索引) | 22 µs | 9 µs |
| 会话回放(100 条记录) | 70 µs | 31 µs |
| SSE 解析(200 帧) | 570 µs | 213 µs |
复算:moon run examples/benchmarks --target js(或 --target wasm-gc)。
#精确,而不是估算
成本算的是 provider 上报的 usage,不是按字符数折算的估算。没有上报时如实计入
no_usage,既不补零也不猜 —— 「不知道」与「是 0」是两回事。
要检验这句话,拿你自己的真实录制作对照即可:
moon run cmd/main --target js -- tokens <你的 cassette.json>它把上报用量与「4 字符 1 token」的估算并排列出(mizchi/llm 的 estimate_tokens
用的就是这条规则,其文档自述为 rough: ~4 chars per token)。
本项目刻意不在文档里给出「差多少倍」的比值:仓库里的示例 cassette 是构造出来的,
基于它们算出的比值同样是编的。数字只能来自真实调用,而上面那条命令会在你的数据上
把它算出来。
#接入 CI
CI 里唯一要做的事就是跑测试 —— 因为回放不需要网络。
三步:
- 开发时录制。 用 Auto 模式跑一遍(命中就回放,未命中就真实调用并记下), 把 tests/cassettes/ 下的文件提交进仓库;
- 测试里回放。 加载 cassette 时自动完成完整性校验,不需要额外的检查步骤;
- CI 里 moon test。 不需要 API Key,也不访问网络。
建议的目录约定(只是建议,代码里怎么写都行):
tests/
  cassettes/
    chat.cassette.json
    streaming.cassette.json
可直接抄走的 workflow 见
examples/github-actions.example.yml,
核心只有两步:
- name: Set up MoonBit
  run: |
    curl -fsSL https://cli.moonbitlang.com/install/unix.sh | bash
    echo "$HOME/.moon/bin" >> $GITHUB_PATH

- name: Replay recorded LLM interactions (no network, no API key)
  run: moon test --target js
测试侧大概是这样:
///|
test "chat completes without a network" {
  let text = @fs.read_file_to_string("tests/cassettes/chat.json")
  let session = @mooncassette.replay_session(text)
  let response = session.send(my_request()) catch {
    error => fail("replay failed: " + error.to_string())
  }
  assert_eq(response.status, 200)
}
三点值得知道:
- 篡改会被挡在加载这一步。 cassette 里存了两个摘要(请求指纹 + 整条记录的摘要), 手工改动任何一个字段,replay_session 就会在解码时报错并指出路径。你不需要为此 写额外的校验步骤,也就不存在「忘了校验」这回事。
- 「没有密钥」这件事是可以被证明的。 CI 里不配置任何 API Key,测试照样全绿; 反过来,若有哪条路径偷偷发起真实调用,它必然失败 —— 回放会话在构造上不持有 Transport。
- 漂移检测是独立的一步。 想知道「换了模型版本之后行为是否变了」,写一个小测试即可:
///|
test "no behavioural drift since the recording was accepted" {
  let old = @codec.decode(@fs.read_file_to_string("tests/cassettes/chat.json"))
  let fresh = @codec.decode(
    @fs.read_file_to_string("tests/cassettes/chat.new.json"),
  )
  let report = @mooncassette.compare_recordings(old, fresh)
  if !report.is_clean() {
    fail("drift detected: " + report.summary())
  }
}「重试后成功」这类路径同样能离线回归:同一请求可以登记一串应答,
见 examples/rate_limit_retry。
只录「最终成功」的话,重试逻辑少一次、多一次、或对不该重试的错误重试,测试都不会变红。
#概念
#cassette
一个 cassette 就是「按录制顺序排列的交互列表」,一个 JSON 文件。它是人类可读的,
可以直接在 code review 里看 diff —— 这正是「键序固定」这一设计的意义。
{
  "format": "mooncassette",
  "version": 2,
  "meta": {
    "generator": "mooncassette/0.6.0",
    "name": "chat-demo",
    "recorded_at": "2026-09-12T08:00:00Z"
  },
  "interactions": [
    {
      "fingerprint": "fnv1a64:9f2c1ab34de5f607",
      "integrity": "fnv1a64:5ae605b113f91e60",
      "request": {
        "body": { "messages": [{ "content": "你好", "role": "user" }] },
        "model": "gpt-4o",
        "provider": "openai"
      },
      "response": {
        "body": { "choices": [] },
        "status": 200,
        "usage": { "input_tokens": 10, "output_tokens": 2 }
      }
    }
  ]
}#两个摘要,两种职责
二者不可互相替代,缺一不可:
| 字段 | 覆盖范围 | 用途 |
|---|---|---|
| fingerprint | 仅请求 | 回放匹配(回放时响应尚不存在,不能纳入);也便于人工排查「为什么没命中」 |
| integrity | 整条记录(含响应) | 防篡改。响应是最容易被手工改动的地方 |
只写 fingerprint 是不够的:如果只校验请求,那么「为了让失败的测试通过、
直接改掉 cassette 里的期望输出」这种做法会悄无声息地溜过去,测试也就失去了意义。
integrity 的存在就是为了堵住这个洞。
#请求规范化
生成指纹前会剔除易变字段(request_id、timestamp、nonce 等),
否则每次调用指纹都不同,回放永远不会命中。默认列表见
@core.default_drop_keys,可自定义。
#匹配策略
| 策略 | 语义 | 适用场景 |
|---|---|---|
| Exact | 指纹相同 且 规范文本全等 | 默认,推荐 |
| FingerprintOnly | 只比指纹,跳过规范文本校验 | 省下的是校验而非计算(实测与 Exact 相当),除非确有理由,否则用 Exact |
| Subset(keys) | 只比请求体顶层指定字段 | 「prompt 一致就算同一次调用」 |
| Sequential | 不比内容,按录制顺序消费 | 调用顺序本身即语义 |
查找采用环形扫描:从当前游标向后找,找不到再从头回卷。这样既能正确处理
「同一请求被录多次、按次序依次回放」,又能在实际调用次数多于录制次数时复用
最早的一条,而不是直接失败。
#匹配的成本与指纹索引
一次匹配的开销几乎全在指纹上:指纹由请求的规范文本导出,单次约等于一次规范化
加一次哈希。若在扫描中对每条记录现算,成本就与记录数成正比。
因此 matcher 提供 MatchIndex:一次性算好整张表的指纹,扫描时只比字符串。
Session 会自动建立并缓存它,录制时同步追加。实测(1000 条记录,js 后端,
数据由 examples/benchmarks 生成):
| 场景 | 无索引 | 有索引 |
|---|---|---|
| 未命中(扫完全表) | 18.8 ms | 22 µs |
| 会话回放(100 条记录) | 1.9 ms | 70 µs |
| 建立索引 | — | 18.3 ms(每份 cassette 一次) |
直接调用 @matcher.find_match 而不传 index 时走的是「逐条现算」路径:结果完全
相同,只是慢,适合一次性查询;重复查询同一份 cassette 时应传入索引。
这也顺带说明了一件事:FingerprintOnly 并不比 Exact 快。两者的差别只在指纹相同
之后要不要再用规范文本确认,而计算指纹本身就需要规范文本——省下的是校验,
不是计算。
#未命中时能看到什么
只报一个指纹几乎没有可操作性——用户无法判断该去补录制、改请求,还是换匹配策略。
因此 NoMatch 的消息里直接带上诊断结论:
mooncassette: no recorded interaction matches request fnv1a64:2b1e... (the cassette has 2
interaction(s); closest is #0 (provider=openai model=gpt-4o), differing at $.body.messages[0].content)
三点刻意的设计:
- 差异只报路径,不报字段值:诊断信息常被写进测试输出或日志,而传进去的请求 未必经过脱敏;
- 路径做排序,候选按「差异最少」稳定排序,因此报告可以被断言、可以逐字比较;
- 「录制条数不够」与「请求对不上」分开报。 顺序模式下游标越界抛 Exhausted 而不是 NoMatch——前者的修法是补录制,后者是改请求或换策略,混在一起会把排查 引向错误的方向。
需要自行格式化时可以调用不抛错的 Session::diagnose:
///|
let diagnosis = session.diagnose(request)
for line in diagnosis.lines() {
  println(line)
}#脱敏
cassette 会被提交进 git、贴进 issue、用于演示,所以脱敏是默认行为:
- 精确键名匹配(authorization、x-api-key、cookie …);
- 后缀匹配(_key、_token、_secret …)——刻意用后缀而非子串, 以免误伤 max_tokens / total_tokens 这类计数字段;
- 字符串值中的密钥形状子串扫描(sk- 后接 8 位以上)。
#漂移检测
回放解决的是「不该变的东西别变」;漂移检测解决的是「该变的东西变了没有」。
你更新了 prompt、换了模型版本,重新录制了一份 cassette。直接看 JSON diff 是读不懂的
(指纹变了、键序也会变)。mooncassette diff 回答你真正关心的三件事:
| 类型 | 含义 |
|---|---|
| Removed | 这个调用在旧录制里有、新的没有 —— 调用被删了,或请求被改动 |
| Added | 只出现在新录制里 —— 新增调用,或请求被改动 |
| Changed | 请求完全相同,但响应变了 —— 这才是真正的模型行为漂移 |
第三类最关键:你的代码一行没改,模型的输出却变了。
两点刻意的设计:
- 请求改动会报成「一条 Removed + 一条 Added」,而不是「一条 Changed」。 因为我们无法判断改后的请求「对应」原来哪一条;与其猜错,不如如实报告。
- 比较前会重新规范化请求。 正常录制出来的请求本就是规范化形态(再规范化是幂等的), 但对手工构造或被外部工具改过的 cassette,这一步能避免把「易变字段残留」误判为漂移。 容错方向是「宁可少报」。
diff 在有漂移时以退出码 1 结束,因此可以直接当作 CI 的一步。
$ mooncassette diff examples/demo.cassette.json examples/demo.drifted.cassette.json
[changed] gpt-4o #0 -> #0  b862439f
drift detected: removed=0 changed=1 added=0 unchanged=1#流式响应
LLM 应用大量使用流式输出。处理原则是:帧完整保留,同时聚合出一个与非流式同形的响应体。
线上            data: {...} ──▶ SSE 文本
                 │
      ┌──────────┴──────────┐
      ▼                     ▼
 Response.stream        Response.body
(原始帧,逐个保留)    (聚合后的最终结果,与非流式同形)
好处是统一模型不必分叉:匹配、漂移检测、成本核算、以及不关心分片的代码只看 body;
需要逐帧重放的场景去看 stream。
- SSE 解析严格按规范(WHATWG HTML §9.2):三种行终止符、多行 data: 以换行连接、 注释行与 id / retry 一并忽略。末尾没有空行时最后累积的帧按规范丢弃—— 与其猜「大概只是漏了个终止空行」,不如少一帧让聚合结果对不上,而不是把一份可能 已被截断的流当作完整流转正。
- 增量按各家语义聚合:OpenAI 的 chat.completion.chunk(含分片发送的 tool_calls[].function.arguments)与 Anthropic 的命名事件(message_start / content_block_delta / message_delta …,含分片到达的 delta.partial_json)。 分片只有拼完才是合法 JSON,所以聚合中途一律只拼接、不解析。
- usage 从流里抽出来:两侧都上报才给出,缺一半时留空而不是补 0—— 补 0 会把「没上报」写成「上报了 0」,那是错误信息而不是缺失信息。
- 帧也要脱敏:帧里装的是同一份模型输出,只脱敏聚合体等于在流式路径上留后门。
- 流式与非流式自动区分:HttpResponse 只带状态码与响应体、没有 Content-Type, 因此按下议内容判断(首个非空行是 data: / event: / 注释行)。
- 回放侧也逐帧递:Session::replay_stream(request, sink) 先拿到响应,再把帧按线上 顺序递回去。录制时「逐块渲染」那段代码在离线回放时同样会被跑到,而它恰恰最容易出错。 非流式响应不触发 sink —— 那是「本来就没有分片」,不是「分片丢了」。
- 客户端自己逐块收数据也能录:decode_openai_stream_frames / decode_anthropic_stream_frames 直接收帧聚合,配合 Session::record 即可把分片回调 攒出来的结果录进 cassette。
- 仓库里的 examples/streaming_demo 端到端跑一遍:录制时逐帧递出、离线回放时逐帧 递出、两者逐帧一致,并顺带给出成本汇总。
#CLI
mooncassette verify  <cassette.json>                 # 解码 + 完整性校验,非零退出码表示失败
mooncassette show    <cassette.json>                 # 打印概要(版本、记录数、token、模型)
mooncassette diff    <old.json> <new.json>           # 报告两次录制之间的漂移,有漂移则退出码 1
mooncassette cost    <cassette.json> <prices.json>   # 按价目表汇总 token 成本
mooncassette tokens  <cassette.json>                 # 上报用量与「4 字符 1 token」估算的对照
mooncassette explain <cassette.json> <request.json>  # 判断请求能否回放,不能则说明差在哪(退出码 1)
mooncassette help
verify 会同时校验两个摘要,因此它可以直接当作 CI 里的一步:
任何被手工改动的 cassette 都会在那里被拦住,并精确定位到
$.interactions[i].integrity。
cost 与 explain 的意义是不开编译器也能查:
- cost 需要一份由你提供的价目表({"模型名": {"input": 微美元/百万, "output": …}},
以 _ 开头的键当作注记忽略)。本项目刻意不内置价格——价格变动频繁,内置一张
会过期的表只会让你拿到「看起来精确、其实已经错了」的数字。汇总里同时给出
priced / unpriced / no_usage 三个计数,让你看得见这个总额覆盖了多少条记录。在仓库里可以直接复算:moon run cmd/main --target js -- cost examples/demo.cassette.json examples/prices.example.json # cost=$0.000210 priced=2 unpriced=0 no_usage=0
- tokens 把 provider 上报的用量与「4 字符 1 token」的估算并排列出,用来回答 「估算离精确有多远」。详见下面的「精确,而不是估算」。
- explain 回答「这个请求为什么回放不出来」,用的是与库内完全相同的诊断路径, 因此输出与测试失败时的错误消息一致:
match: no
policy=Exact  cursor=0  interactions=1
#0 provider=openai model=gpt-4o differs: $.body.api_key (only in the request), $.body.model (only in the recording)参数解析刻意不依赖位置(不同后端 @env.args() 语义不一致),
而是扫描已知子命令关键字,因此 native 与 js 上行为一致。
这些命令目前不单独发布成可安装的二进制,仓库内用
moon run cmd/main --target js -- <子命令> 运行。若你是在自己的项目里使用本库,
等价能力直接调用库 API(@codec.decode、@drift.compare、@recorder.Session::diagnose)
即可 —— CLI 的价值是排查时不必开编译器,而不是充当唯一的入口。
#设计取舍(已知边界)
诚实列出,避免误用:
| 取舍 | 原因 | 影响 |
|---|---|---|
| 规范文本不区分 1 与 1.0 | JSON 只有一种数字类型;解析器会归一为 1 | 若需区分整数/浮点,请自行在业务层编码 |
| 非有限数(NaN/Inf)写成 null | JSON 无法表示它们 | 不会产出非法 JSON,但会丢失该值 |
| 指纹用非密码学哈希 | 只做索引,一致性由文本全等兜底 | 无安全影响 |
| integrity 用非密码学哈希 | 目的是检出误改,不是防恶意伪造 | 需要防伪造请配合签名/权限控制 |
| 脱敏只按键名判断 | 值里混进密钥无法可靠识别 | 已用 sk- 形状扫描部分缓解;敏感场景请人工复核 |
| 不记录耗时 | 耗时是非确定字段,进入 Interaction 会破坏可复现性 | 需要延迟断言请在业务层另行测量 |
| 库本体不含 fs/http 依赖 | 保持纯计算、全后端可编译 | 文件读写与网络由使用方接入 |
#测试与验证
moon test --target wasm-gc   # 默认目标
moon test --target js        # 交叉验证
moon check --target js
moon fmt && moon info
当前 296 个测试全部通过,覆盖十二个包,且在 wasm-gc 与 js 两个目标上各跑一遍。
examples/benchmarks 另外打印一组规模指标(确定性,只取决于数据本身)与一组
时间指标(取决于机器与后端):把两者分开,是为了避免「CI 机器今天有多忙」变成
一条会漂移的断言。
测试的重点不是行数,而是每条不变量都有对应断言,例如:
- FNV-1a 用官方测试向量校验(空串 / "a" / "foobar");
- 规范文本的键序、转义、幂等性;
- 环形查找的推进与回卷边界(白盒直测私有算术);
- 篡改请求体、响应体、状态码、token 用量都必须被检出;
- 脱敏不能误伤 max_tokens / total_tokens;
- 真实调用的请求必须保留密钥(用记录型 Transport 断言);
- 带密钥的请求「录制后立刻回放」必须命中(回归测试);
- 回放模式下 Transport 调用次数必须为 0;
- 漂移检测:键序/易变字段变化不算漂移,而响应变化必须算;
- 漂移检测:重复的同一请求按出现顺序两两配对,报告顺序固定为 Removed → Changed → Added;
- 协议解码用真实 API 形状的报文(含 429 错误体、HTML 网关错误页、非整数 token 数)验证;
- 诊断:差异路径按字典序排序(Map 迭代顺序不保证稳定,不排序就无法断言);
- 诊断:差异数量相同时保持录制顺序(稳定排序);
- 诊断:$.model 与 $.body.x 能分别定位,「只在记录里」「只在请求里」与数组长度差都会被报出;
- 顺序模式耗尽抛 Exhausted,空 cassette 报 NoMatch——两者不可混;
- 手动录入(Session::record)与自动录制产出同一形态,且「录完立刻回放」必须命中;
- 手动录入绝不触碰 Transport(这是异步接入的前提);
- 手动录入返回的是脱敏后的响应,与回放返回的内容一致(否则首次运行与后续运行会看到不同的值);
- SSE:三种行终止符、多行 data: 连接、注释与未知字段忽略、BOM、空帧、以及「末尾无空行则丢弃」;
- SSE:render ∘ parse 收敛,且非 ASCII 载荷不错位(索引与切片全部按字符进行);
- 事件流识别不误判 JSON、HTML 与「database error」这类前缀相似的纯文本;
- 流式聚合:分片的 tool_calls.arguments 与 partial_json 只有拼完才解析;
- 流式聚合:纯 tool call 的流写成 content: null 而非空串(两者语义不同);
- 流式聚合:usage 缺一半时留空,而聚合体里补 0——「没上报」与「上报了 0」可区分;
- 流式聚合:错误帧原样作为响应体,不再被继续聚合;
- 流式:帧内容落盘前必须脱敏(否则流式路径会绕开「落盘必脱敏」);
- 流式回放:replay_stream 把帧按录制顺序递出,且「录制时递出的帧」与「回放时递出的帧」逐帧一致;非流式响应不触发 sink;
- 流式:帧级聚合入口与响应级入口给出完全一致的结果(两者只是「谁来解析帧」不同);
- 格式版本:旧版本(version 1)仍可读;「读入旧版本 → 写出旧版本」字节稳定; 追加流式记录后写出版本自动升到 2,不会写出「自称旧格式、其实含新字段」的文件;
- 诊断:差异路径按码点字典序排序(String 自带的比较不是字典序,实测表现为先比长度);
- 成本:整数算术的取整方向是确定的,同一输入恒得同一金额;未知模型报「未知」而不是 0;
- 成本:token 数 × 价格 用 Int64(MoonBit 的 Int 是 32 位,用 32 位会静默溢出);
- 对抗性矩阵:篡改 cassette 的每一个字段都必须被检出,且错误消息指出路径; 同时钉住 meta / version 不该报警——过度报警会让人学会忽略警告,比不报警更糟;
- 脱敏性质测试:300 组确定性随机结构,密钥以三种包装形式随机埋入任意层级, 断言序列化结果中永不出现;另验证脱敏幂等、max_tokens / total_tokens 不被误伤;
- 解析器模糊测试:对抗语料 + 600 组随机输入不崩,且 render ∘ parse 幂等;
- 形状矩阵:有无 usage、有无帧、空容器、非 ASCII、控制字符、状态码 0、 以及 20 条记录的顺序,全部稳定往返(断言的是再编码后的字节相等);
- 脚本化应答序列:同一请求按注册顺序依次给出、用完重复最后一个;on 是追加而不是覆盖 (覆盖语义会在「我只想再补一条」时悄悄丢掉先前那条,正是重试序列最容易踩的坑);
- 重试路径:429 → 200 的序列可以离线复现,且回放阶段一次网络调用都不发生;
- 调用次数超出录制条数时,环形策略复用最早一条、顺序策略抛 Exhausted —— 两种行为都被钉住;
- 指纹索引:有索引与无索引在每个策略、每个游标下给出同一个命中下标 —— 索引若改变结果, 症状是「回放出了另一个响应」而不是报错,属于最难查的一类错误;
- 指纹索引:录制期间不断追加后仍与记录逐位对齐,50 条记录按序命中无错位;
- 子集策略在有索引与无索引下结果一致(它本就用不上整请求指纹)。
#包结构
| 包 | 职责 | 是否依赖 IO |
|---|---|---|
| canon | 规范 JSON 文本 + 稳定哈希 | 否 |
| core | 数据模型、规范 JSON 视图、错误、请求规范化 | 否 |
| fingerprint | 请求指纹、完整性摘要、等价判据 | 否 |
| matcher | 四种匹配策略与环形查找 | 否 |
| sanitize | 脱敏策略与递归脱敏 | 否 |
| codec | cassette 编解码与完整性校验 | 否 |
| drift | 两次录制之间的漂移检测 | 否 |
| providers | OpenAI / Anthropic 协议编解码(含流式聚合)、HTTP 执行器抽象 | 否 |
| stream | SSE 帧解析与渲染 | 否 |
| cost | 按价目表做成本核算 | 否 |
| recorder | Transport 抽象、会话引擎、MockTransport | 否 |
| mooncassette | 门面:最短上手路径 | 否 |
全部子包都是纯计算包,可在 wasm / wasm-gc / js / native 后端编译。
真实网络与文件系统由使用方通过 Transport 与自有 IO 接入
(仓库内的示例与 CLI 使用 moonbitlang/x,属于外层壳)。
#已完成
| 版本 | 内容 |
|---|---|
| 0.1.0 | 数据模型与规范 JSON 文本、跨目标稳定指纹、四种匹配策略、脱敏、cassette 编解码与双摘要完整性校验、会话引擎、verify/show CLI、离线示例 |
| 0.2.0 | 漂移检测(drift 包 + mooncassette diff);示例演示「模型换版本后行为漂移」的完整闭环 |
| 0.3.0 | 协议适配与未命中诊断:providers(OpenAI / Anthropic)、Session::record 手动录入路径(异步客户端的接入方式)、Session::diagnose 与可读的未命中消息;修复顺序模式耗尽被误报为 NoMatch、generator_id 与模块版本脱钩 |
| 0.4.0 | 流式响应:SSE 帧解析、OpenAI / Anthropic 增量聚合、以及回放侧的逐帧重放(Session::replay_stream);cost 成本核算;CLI 新增 cost 与 explain。新增 stream 与 cost 两个包;cassette 格式版本升到 2,读取端兼容 1–2 |
| 0.5.0 | 「别人能照着用」:CI 接入指南(中英 README 各一节 + 可直接复制的 GitHub Actions 示例)、限流重试示例与脚本化应答序列(ScriptedReplies)、基准套件 examples/benchmarks(并据此修掉扫描中重复计算指纹的问题:1000 条记录未命中 18.8 ms → 22 µs,会话回放 1.9 ms → 70 µs)、可视化 Demo(5 个视图 + 截图)、异步适配层(独立模块)、CLI 新增 tokens;另修正若干「文档与实现不符」之处(FingerprintOnly 被误称为性能逃生通道、replay_session 的参数名、SSE 起始行判据) |
| 0.6.0 | 二进制与多模态载荷:providers 按响应体内容决定承载方式(JSON / 原文 / 载荷信封),非文本字节不再被有损解码成替换字符;base64 归一化后进指纹,同一份字节的等价写法共用一个指纹;超过阈值的大载荷直接进信封;脱敏视图新增折叠与截断(fold / fold_json);新增 payload 包 |
#许可
Apache-2.0
auto_session
创建自动录制会话。
语义为「命中就回放、未命中就录制」:首次运行会调用真实 Transport
并把结果并入 cassette,之后运行则完全离线。这是推荐的日常开发流程。
compare_recordings
比较两份录制,返回漂移报告。
典型用法:把通过验收的 cassette 提交进版本控制;日后换了模型版本
或在改了 prompt 之后重新录制,跑一次对比就能回答「模型行为变了没有」。
报告区分三类:调用被删(Removed)、调用新增(Added)、
以及请求没变但响应变了(Changed)——最后一类才是真正的行为漂移。
record_session
创建纯录制会话。
replay_session
创建只读回放会话。
这是最安全的入口:不会发起任何真实调用,未命中即报错。
适合在 CI 与单元测试中使用。
参数是 cassette 的 JSON 文本(不是文件路径)。读取文件由调用方完成,
因为本库刻意不依赖 fs:任何后端(含浏览器)都能用同一套 API。
let text = @fs.read_file_to_string("tests/cassettes/chat.json")
let session = @mooncassette.replay_session(text)Source Files
Install
Download zipDeterministic record-and-replay (cassette) for LLM interactions: write offline, reproducible, drift-detecting regression tests for LLM applications without API keys or network.
llmtestingrecord-replaycassettevcrdeterministicmockregression-testing

 Apache-2.0

 Updated 3 hours ago
 26 downloads
Dependencies
- moonbitlang/x0.5.5